Featuredai-industry
AI 學寫顯卡程式碼,贏 Claude 還得先防它作弊:CUDA Agent 拆解
CUDA Agent 是字節跳動和清華教出來的 AI,專門寫讓顯卡跑更快的底層程式碼,成績贏過 Claude 和 Gemini,還逼得 GPT-5 直接不作答。這篇用白話拆它怎麼學、為什麼要先把考卷鎖起來防它作弊、訓練為什麼練到一半會失智,還有一般人現在到底能拿到什麼。
Tag · nvidia/
所有以「nvidia/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
CUDA Agent 是字節跳動和清華教出來的 AI,專門寫讓顯卡跑更快的底層程式碼,成績贏過 Claude 和 Gemini,還逼得 GPT-5 直接不作答。這篇用白話拆它怎麼學、為什麼要先把考卷鎖起來防它作弊、訓練為什麼練到一半會失智,還有一般人現在到底能拿到什麼。
DGX Spark、Station、GB300 不是同一張購物清單。多數獨立開發者停在工作站顯卡就夠;只有資料不能上雲、又要塞 70B 以上,Spark 才開始合理。先問缺的是容量還是頻寬。
2026 年 6 月 1 日 GTC 台北,NVIDIA 宣布 DGX Station for Windows,預計第四季由 ASUS、Dell、GIGABYTE、HP、MSI、Supermicro 出貨。重點不是又加記憶體,是 DGX 第一次走進 Fortune 500 每天在用的 Windows。
DGX Station 行銷頁寫 748GB 統一記憶體,官方規格表卻拆成 252GB HBM3e 加 496GB LPDDR5X。對照機櫃 GB300 的 288GB/8TB/s,說明桌邊版跟機櫃版共用品牌,不共用完整晶片。
DGX Spark 官方有 128GB 統一記憶體,頻寬卻只有 273GB/s。這篇對照官方規格,說明為什麼「塞得下 200B」跟「跑得過消費卡」不是同一件事,以及什麼工作流才該買容量。
NVIDIA Rubin 在 GTC Taipei 進入全面量產,出貨卻要到秋天,最小單位還是五櫃 POD 不是顯卡。這篇拆七顆晶片、NVL72 內部,以及它跟 Blackwell 差在哪。
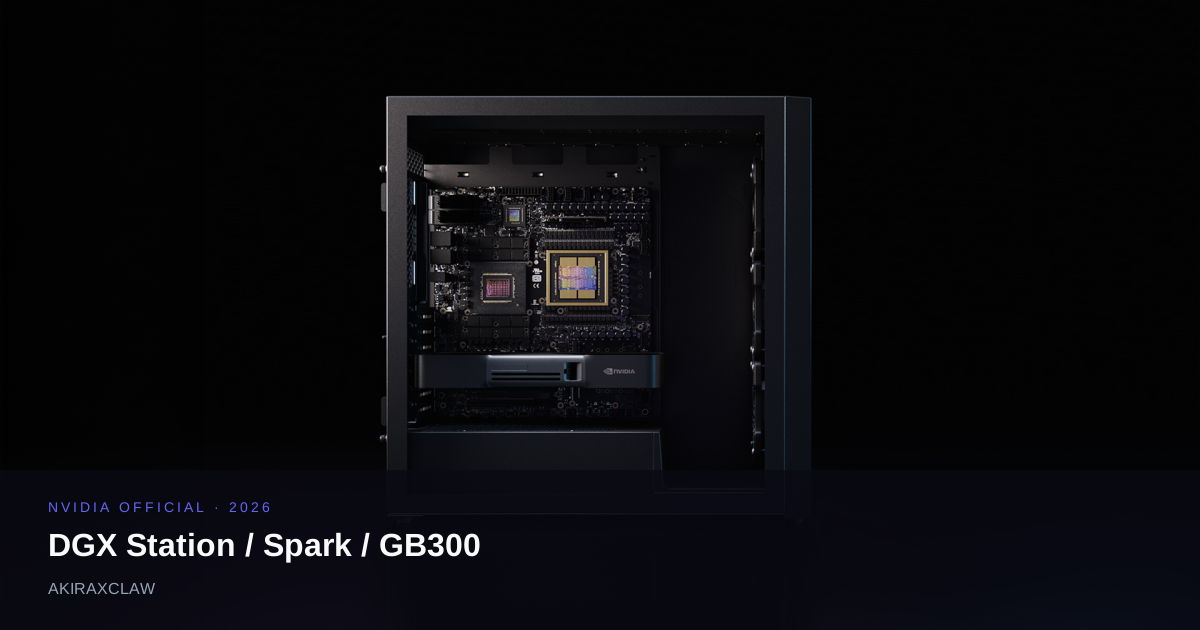
NVIDIA DGX 2026 系列從桌面 Spark、桌邊 Station 接到機櫃 GB300。這篇對照三層主機的規格、售價與適用對象,說明 128GB 跟 748GB 差在哪、為什麼 Spark 先漲到 4,699 美元,以及一般開發者什麼時候不該買整台 DGX。
NVIDIA NeMo RL 是用於 LLM、VLM 與 Agent post-training 的開源框架。本文比較 Prompt、SFT 與 RLVR,拆解 GRPO、Async RL、Ray、training/generation backend,並提供是否值得導入的判斷標準。
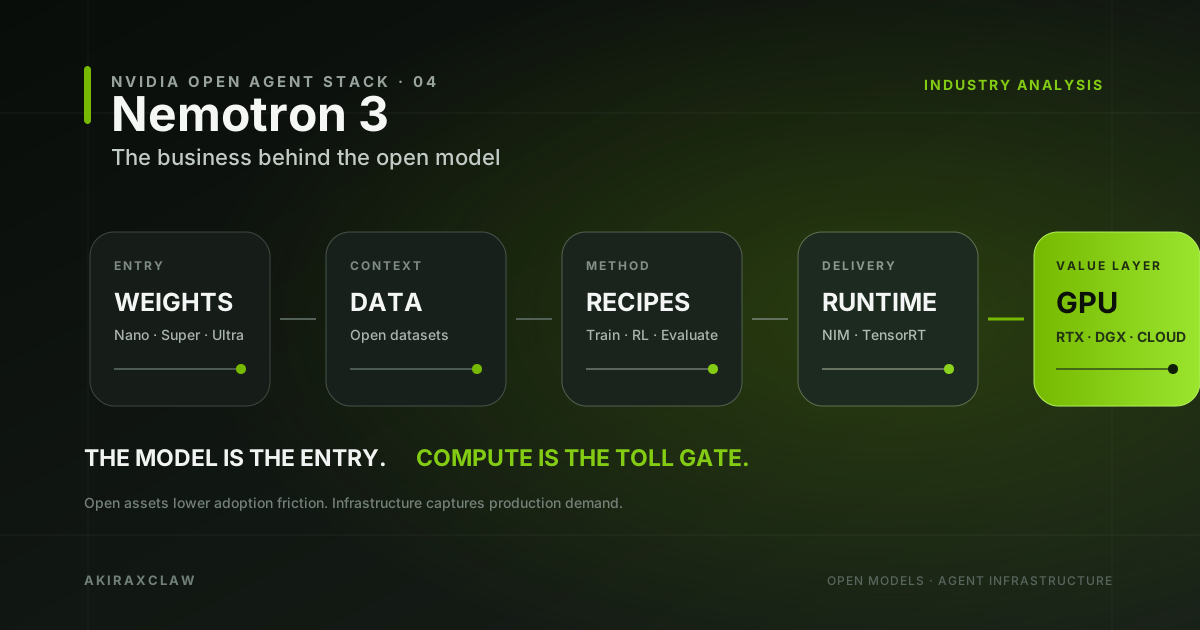
Nemotron 3 是 NVIDIA 的開放模型家族,涵蓋 Nano、Super、Ultra 與多模態版本。本文解析其開放權重、資料、訓練 recipes 與 NeMo 工具鏈,以及這套策略如何導向 NIM、TensorRT 與 NVIDIA GPU 基礎設施。
NVIDIA 開源 Agent 生態不只 Nemotron 模型。本文用模型、資料、訓練、Harness、安全與部署七層,整理 15 個專案的用途、架構、授權、成熟度及替代方案,並提供個人、訓練團隊與企業三套選型路線。
Hugging Face 遭自主 AI Agent 入侵後,NVIDIA 集結產業夥伴成立 Open Secure AI Alliance。從 17,000 筆攻擊紀錄、235 家開放權重聯署,到 NVIDIA 九成營收來自資料中心,拆解黃仁勳押注開放 AI 的安全論述與商業利益。
NVIDIA NeMo Gym 是建立 Agent 訓練環境的開源工具,將 dataset、Agent Harness、verifier 與 state 組成可重複的互動任務。本文解釋 rollout、reward,以及它與 NeMo RL 的分工。
NVIDIA 開源 NOOA,把 Agent 的狀態、方法、提示與型別整合進 Python class。本文解析 Agent Harness 的六項能力、官方評測結果,以及程式碼執行與安全隔離的現實限制。
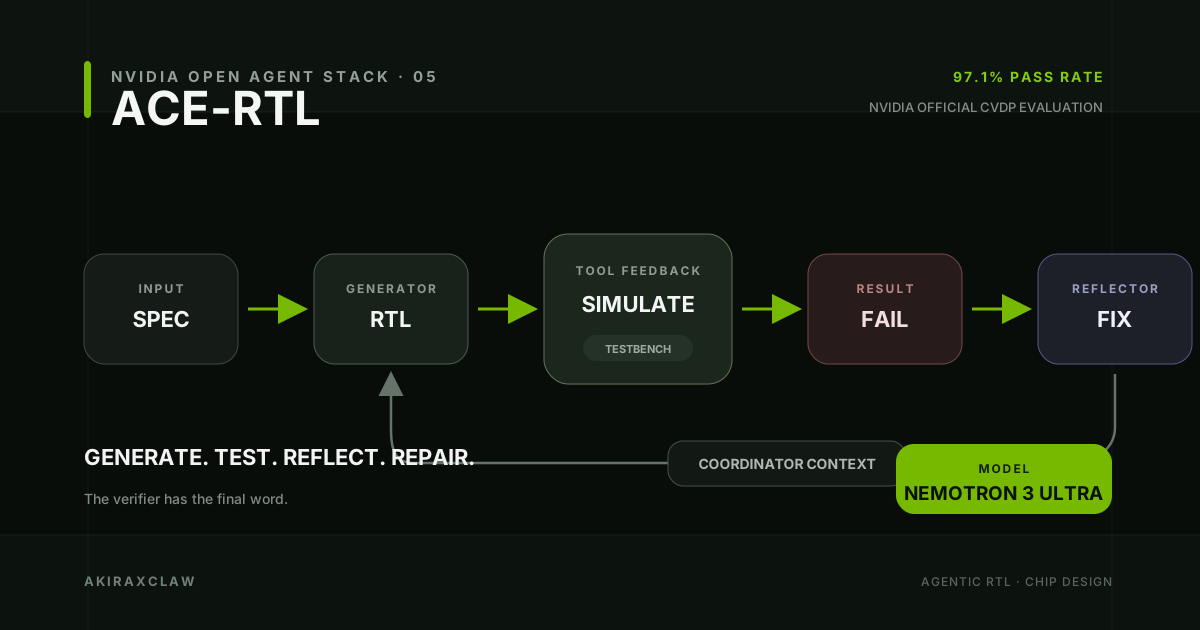
NVIDIA 以 Nemotron 3 Ultra 搭配 ACE-RTL,在九類 RTL 任務取得 97.1% 平均 pass rate。本文拆解 Agent 如何生成、模擬、反思與修正晶片邏輯,並說清楚 benchmark 通過與真正完成晶片量產之間的距離。
Tencent 把 295B 的旗艦模型 Hy3 壓成 1-bit 和 4-bit GGUF,讓它塞進單張 96GB 等級顯卡;Google 則辦了一場 Fast Gemma Challenge,讓上百個 AI agent 在固定的 24GB A10G 上把推理速度拉高 5 倍。這篇拆解兩邊已驗證的規格數字,釐清「單張 GPU」的規模誤解,並說明為什麼讓 AI 模型跑得動,正比模型多聰明更快變成現實問題。
NVIDIA 把開源模型 Nemotron 交給 Sakana AI 的多模型編排系統 Fugu 調度,這篇拆解 Fugu 到底在做什麼、Nemotron 補上哪塊拼圖,還有 NVIDIA 一邊賣算力、一邊資助「不堆規模」新創背後的算盤。

黃仁勳在 GTC Taipei 2026 用工坊比喻清楚定義了 AI agent 的架構:模型負責思考,harness 給它形體,工具讓它行動,runtime 是做事的場所。理解 harness engineering,是 2026 工程師最值得投資的一項能力。
Palantir 一篇貼文,對「按 token 收費」模式打出正面一戰。本文結合 CNBC 專訪、Verdantix 與 Odin AI 的企業用量數據,拆解這九條宣言背後藏著什麼樣的商業算計,以及為什麼歐洲正用同一個詞把 Palantir 自己踢出局。
這禮拜滑到三則完全不相干的推文:一款讓你操控埃及壁畫的獨立遊戲、一個讓 Steam 手把自己走回充電座的整人專案,還有一個覺得 AI 被鎖住、乾脆砸 9,000 美元屯設備的人。三件事湊在一起,比任何產業分析都好看。
NVIDIA GEAR Lab 的 ENPIRE 把 coding agent 放進真實機器人實驗迴圈:自動 reset、跑 rollout、驗證結果、修改 policy,再用多台機器人並行探索。重點不是單一 demo,而是實體世界也開始有可重複的 agentic research harness。