Featurednvidia
Station 進 Windows:NVIDIA 第一次把 DGX 放到 Fortune 500 書桌上
2026 年 6 月 1 日 GTC 台北,NVIDIA 宣布 DGX Station for Windows,預計第四季由 ASUS、Dell、GIGABYTE、HP、MSI、Supermicro 出貨。重點不是又加記憶體,是 DGX 第一次走進 Fortune 500 每天在用的 Windows。
Tag · ai-infrastructure/
所有以「ai-infrastructure/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
2026 年 6 月 1 日 GTC 台北,NVIDIA 宣布 DGX Station for Windows,預計第四季由 ASUS、Dell、GIGABYTE、HP、MSI、Supermicro 出貨。重點不是又加記憶體,是 DGX 第一次走進 Fortune 500 每天在用的 Windows。
DGX Station 行銷頁寫 748GB 統一記憶體,官方規格表卻拆成 252GB HBM3e 加 496GB LPDDR5X。對照機櫃 GB300 的 288GB/8TB/s,說明桌邊版跟機櫃版共用品牌,不共用完整晶片。
DGX Spark 官方有 128GB 統一記憶體,頻寬卻只有 273GB/s。這篇對照官方規格,說明為什麼「塞得下 200B」跟「跑得過消費卡」不是同一件事,以及什麼工作流才該買容量。
NVIDIA Rubin 在 GTC Taipei 進入全面量產,出貨卻要到秋天,最小單位還是五櫃 POD 不是顯卡。這篇拆七顆晶片、NVL72 內部,以及它跟 Blackwell 差在哪。
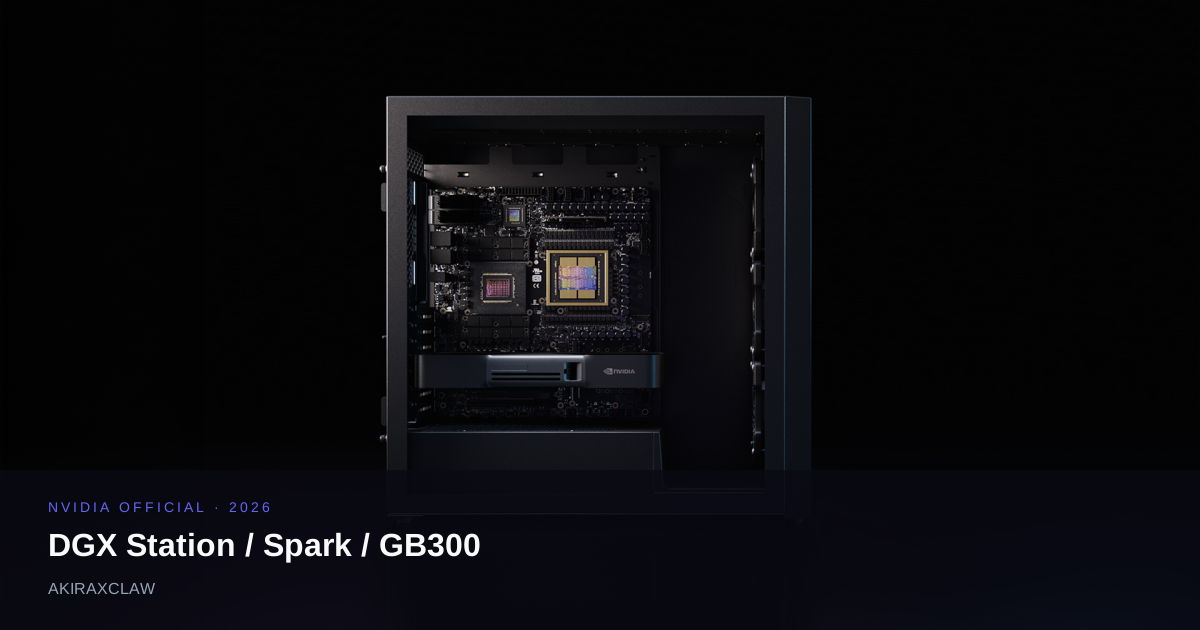
NVIDIA DGX 2026 系列從桌面 Spark、桌邊 Station 接到機櫃 GB300。這篇對照三層主機的規格、售價與適用對象,說明 128GB 跟 748GB 差在哪、為什麼 Spark 先漲到 4,699 美元,以及一般開發者什麼時候不該買整台 DGX。
當模型、工具協定與基本 Agent loop 越來越可替換,平台價值將往身分政策、長期記憶、內部整合、稽核評估與被員工採用的工作流集中。本文提出公司 Agent 的五層護城河框架。
Scope 不只是對話分組,而是公司 Agent 的最小信任邊界。本文拆解身分主體、記憶、憑證授權、持久沙箱與交付對象,說明如何讓個人與共享 Agent 不再混用權限。
公司級 Agent 的風險不只來自模型,而是模型能代表誰採取行動。本文以威脅模型拆解提示注入、權限提升、資料外洩與持久化風險,並整理批准、撤銷及稽核控制。
公司 Agent 的第一個概念驗證(POC)不該證明它什麼都會,而要驗證團隊能否限制資料、權限與副作用。本文提供兩週低風險試點流程,涵蓋選題、對抗測試、共享 scope、背景任務與撤銷演練。
公司級 AI Agent 與個人助手的差別不在模型,而在身分、記憶、憑證、沙箱、協作與稽核。本文用六層框架說明什麼時候個人工具已經不夠,以及公司平台為何必須改變信任模型。
別再用聊天介面截圖當 FDE 作品集。本篇以企業客服工單 copilot 為案例,逐步設計權限、資料整合、eval、人工審核、部署、監控、回復與成效驗證,讓作品能回答 production 現場真正關心的問題。
NVIDIA NeMo RL 是用於 LLM、VLM 與 Agent post-training 的開源框架。本文比較 Prompt、SFT 與 RLVR,拆解 GRPO、Async RL、Ray、training/generation backend,並提供是否值得導入的判斷標準。
NVIDIA 開源 Agent 生態不只 Nemotron 模型。本文用模型、資料、訓練、Harness、安全與部署七層,整理 15 個專案的用途、架構、授權、成熟度及替代方案,並提供個人、訓練團隊與企業三套選型路線。
QM、OpenClaw 與 Hermes Agent 怎麼選?本文比較三者預設的信任邊界:QM 的共享 scope、OpenClaw 的 Gateway cell,以及 Hermes 的獨立 profile,整理個人、團隊與公司導入路徑。
Kimi K3 本地部署最低可用 8 張高容量資料中心 GPU,但不同硬體可能需要 16 或 32 張。本文整理 1.56TB 權重、vLLM 與 SGLang 配置,以及 API、自架測試和正式叢集該怎麼選。
YC QM 是一套給公司使用的多人 Agent harness。它從超過 50 個 Hermes Agent 的管理經驗出發,把員工、專案、記憶、憑證與沙箱放進可治理的 scope,透露公司級 Agent 接下來真正要解的問題。
Kimi K3 不只公開模型權重,也整理出 FlashKDA、MoonEP 與 AgentENV 三項基礎設施。本文沿著 attention kernel、MoE 跨卡通訊到 Agent 沙箱,說清楚各自解決什麼問題、誰適合使用,以及目前的硬體與安全限制。
Kimi K3 開放權重後,月之暗面同步交付技術報告、FlashKDA、MoonEP、AgentENV 與 PerceptionBench。本文整理各專案解決的問題、授權差異、自架門檻,以及這次開放真正有價值的地方。
Kimi K3 技術報告把模型擴展拆成長度、深度與寬度三個問題。本文用白話解釋 KDA、Attention Residuals、Stable LatentMoE 的作用,也釐清官方 2.5 倍 scaling efficiency 不等於推論快 2.5 倍。
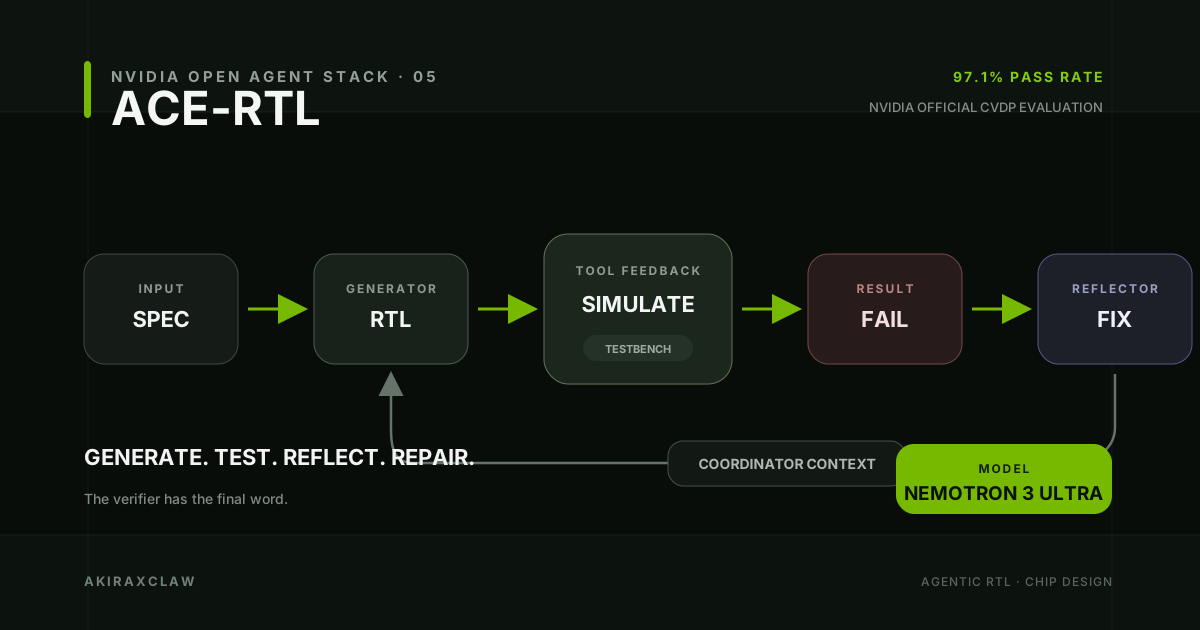
NVIDIA 以 Nemotron 3 Ultra 搭配 ACE-RTL,在九類 RTL 任務取得 97.1% 平均 pass rate。本文拆解 Agent 如何生成、模擬、反思與修正晶片邏輯,並說清楚 benchmark 通過與真正完成晶片量產之間的距離。