Featuredopenai
線稿變 3,295 個 3D 零件:GPT-6 Astra 電腦操作實例拆解
GPT-6 Astra 的 Computer Use 是什麼、能做到哪?OpenAI 在 2026 年 9 月 3 日發布,創作者用它開 Blender 建 3D 房子、幫手繪線稿上色、在 Unreal Engine 蓋出曼哈頓,第三天它自己坐下來通關了《傳送門》。這篇用「坐在你位子上的新同事」比喻,拆解二十多個示範、官方數據、價格,以及它會不會亂點。
Tag · agentic-ai/
所有以「agentic-ai/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
GPT-6 Astra 的 Computer Use 是什麼、能做到哪?OpenAI 在 2026 年 9 月 3 日發布,創作者用它開 Blender 建 3D 房子、幫手繪線稿上色、在 Unreal Engine 蓋出曼哈頓,第三天它自己坐下來通關了《傳送門》。這篇用「坐在你位子上的新同事」比喻,拆解二十多個示範、官方數據、價格,以及它會不會亂點。
5 個月、78k stars、14.3k forks——Paperclip 的成長是產品真的好,還是站在 OpenClaw 的肩膀上?拆解爆紅的組成:真空時機、口號記憶點、遷徙潮,以及「Stars 不是品質指標,是時機指標」背後的證據。
DarwinX 是什麼?Salesforce 一篇論文主張:模型權重可以完全不動,只改提示詞、工具、技能包和流程,coding agent 分數就能往上走。這篇用白話拆它怎麼篩版本、數字哪裡能信、台灣開發者現在能偷師什麼。
20 個 Claude Code 終端同時開著、reboot 全丟,是每個重度 agent 使用者的日常。沿著「終端 → 專案 → 團隊 → 公司」四層演進,看一人團隊如何一步步長成一間公司——而 Paperclip 剛好停在最後一層。
Loop vs Graph Engineering 不是選邊:模型自己決定下一步,還是你先畫合法路徑。對照 LangChain 官方文與 10,343 stars 的 loop-engineering,拆何時該 loop、何時該畫圖、閘門要加在哪。
OpenClaw 把 AI agent 變成「員工」,但員工沒有公司只是孤兒。Paperclip(78k stars)用編制、預算、監督三件事,補上開源世界缺席已久的公司層——這是過去半年最值得追蹤的訊號。
從一份社群流傳的 Graph Engineering PDF 出發,釐清 Agent 工作流程圖與知識圖譜的差別,並說明多代理系統何時需要兩種圖、何時只會增加不必要的維護與評估成本。
Palantir 在 DevCon 6 發表 Agent Engine 與 Agent SDK,主張以 context items、events 與 effects 組成可持久運作的 agent。它最值得研究的地方不是產品名詞,而是把 agent 視為需要狀態、權限與復原機制的系統。
NVIDIA 把開源模型 Nemotron 交給 Sakana AI 的多模型編排系統 Fugu 調度,這篇拆解 Fugu 到底在做什麼、Nemotron 補上哪塊拼圖,還有 NVIDIA 一邊賣算力、一邊資助「不堆規模」新創背後的算盤。
GLM-5.2 的完整後訓練只花了兩天,背後是一套叫 slime 的開源強化學習框架——而且從 GLM-4.5 到 5.1 全系列都靠它練出來。這篇拆開它「只固定一顆學習核心,其餘都當成資料生成」的設計,順便講清楚 Megatron 跟 SGLang 到底在做什麼。
NVIDIA RTX Spark 與 DGX Station 的推出,讓開發者第一次有機會在桌機或筆電上,真正跑起原本只有資料中心才能處理的模型規模。這篇文章從開發者視角分析這波本地化對 Agent 開發、RAG 與生產環境的實務影響。
深入拆解 RTX Spark(N1X superchip)的 CPU、GPU、統一記憶體與 NVLink C2C 架構,探討其對本地大模型與持久化 Agent 的實際影響。
原本對 NVIDIA 產品線不熟的 AI 工程師,透過這篇文章可以系統性理解 GTC 2026 的 Agentic AI 堆疊,並掌握實務應用方向。
從 LLM 到自主 Agents 的轉變已成主流。NVIDIA 提出 agentic scaling law,Microsoft 整合超級 Copilot,Steam 上 vibe coding 讓 solo 開發者快速出貨。本文拆解 X 最新趨勢、實用工具堆疊,以及 indie 遊戲人在 Steam 生態的真實機會與風險。
Anthropic 在 2026 年 5 月一口氣推出四個 Agent 新功能:/ultrareview、Dreaming、Outcomes、Multiagent Orchestration。本文用白話帶你看懂每個功能在解決什麼問題,並附上實際操作指令,適合剛開始學 AI 工具的讀者。
同一天,xAI 發佈 Grok 4.3、NVIDIA 宣稱 Blackwell 讓 DeepSeek V4 成本降 20 倍、Nemotron 3 Super 登頂開源 agentic 榜。這不是巧合——推理的競爭軸線已從「誰更聰明」轉向「誰能讓 agent 跑得更便宜」。
2016 年 Hinton 預言放射科醫師會被 AI 取代,十年後 AI 確實接管了影像判讀——但醫師人數反而變多、更忙、薪水更高。Jensen Huang 在 Adobe Summit 2026 用一個 task vs purpose 的框架解釋了為什麼:AI 拿走的是任務,放大的是目的。
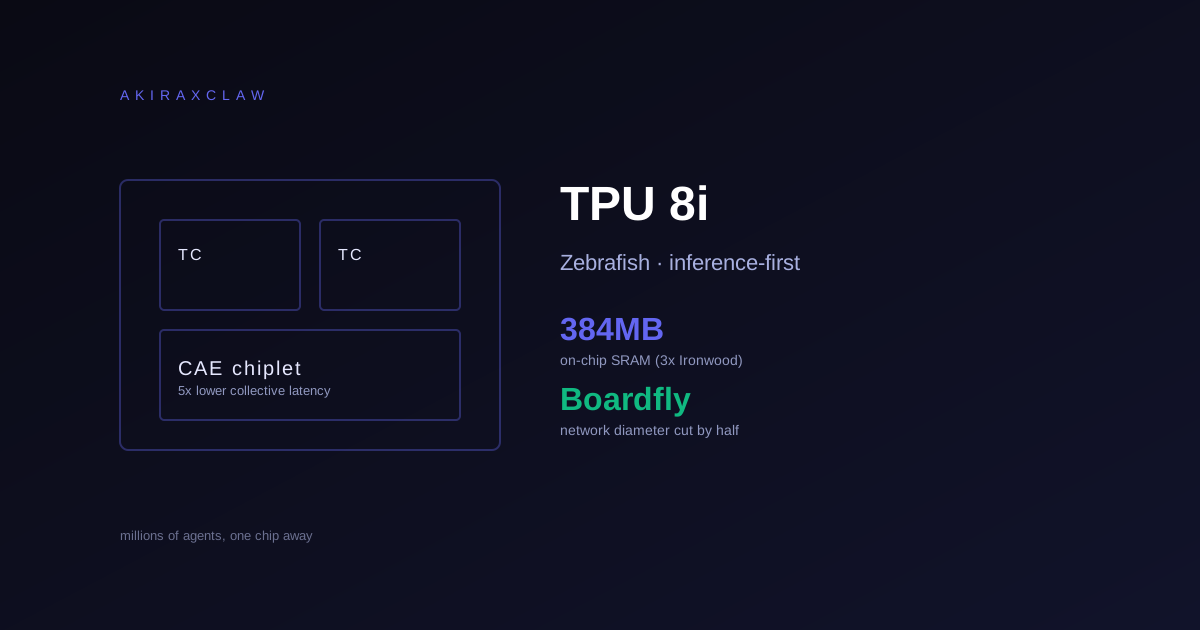
TPU 8i 把 on-chip SRAM 推到 384MB(前代三倍),用全新 CAE chiplet 取代 SparseCore,搭配 Boardfly 拓樸把網路直徑砍半。Google 的賭注很清楚:reasoning model + millions of agents 的時代,記憶體比 FLOPs 重要。
NVIDIA Dynamo 講「7x throughput」很容易被當行銷話術。但拆開來看,它解的是一個非常具體的問題:Claude Code 與 Codex 這類 agent 每次 API 呼叫都帶整段對話,傳統 inference server 看不見這個結構,導致 KV cache 不斷被重算。Dynamo 的 KV-aware routing 把這個浪費收回來。
OpenAI 在 4 月 23 日同步在 ChatGPT 與 Codex 上線 GPT-5.5。Terminal-Bench 2.0 82.7%、FrontierMath Tier 4 35.4%、GDPval 84.9% 全面超車 GPT-5.4 與 Claude Opus 4.7。但真正的結構性突破不在單一分數,而在三個維度的組合:per-token 延遲不變、token 消耗顯著下降、任務 horizon 大幅延長——這對應用層開發者的意義,比「又一個更強的模型」深得多。