Featuredai-agent
Agent 平台的護城河:模型之外,什麼留得住
當模型、工具協定與基本 Agent loop 越來越可替換,平台價值將往身分政策、長期記憶、內部整合、稽核評估與被員工採用的工作流集中。本文提出公司 Agent 的五層護城河框架。
Tag · ai-industry/page/2/
所有以「ai-industry/page/2/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
當模型、工具協定與基本 Agent loop 越來越可替換,平台價值將往身分政策、長期記憶、內部整合、稽核評估與被員工採用的工作流集中。本文提出公司 Agent 的五層護城河框架。
公司級 AI Agent 與個人助手的差別不在模型,而在身分、記憶、憑證、沙箱、協作與稽核。本文用六層框架說明什麼時候個人工具已經不夠,以及公司平台為何必須改變信任模型。
一則熱門貼文把 FDE 說成低門檻、高薪的新紅利。本篇用 OpenAI、Palantir、Harvey 等官方職缺逐項查證,說明哪些訊號是真的、哪些被過度延伸,以及 Java 與前端能力如何轉成企業 AI 導入優勢。
這份常青指南整理 Forward Deployed Engineer 的角色邊界、能力地圖、轉職路線、作品集與面試現實,並用動態目錄收錄系列文章,讓台灣工程師依目前階段找到下一篇該讀的內容。
FDE 面試不只考演算法,也會檢查問題拆解、系統設計、客戶溝通與 production 判斷。本篇整理官方招聘流程、高薪樣本的正確解讀、出差與情境切換,以及未來回到產品或工程職涯的條件。
FDE、FDSE、Solutions Engineer 與 AI 顧問常被混用,但 coding 深度、介入客戶的階段、交付責任與績效指標並不相同。本篇用官方職缺拆解四種角色,提供比職稱更可靠的判讀方法。
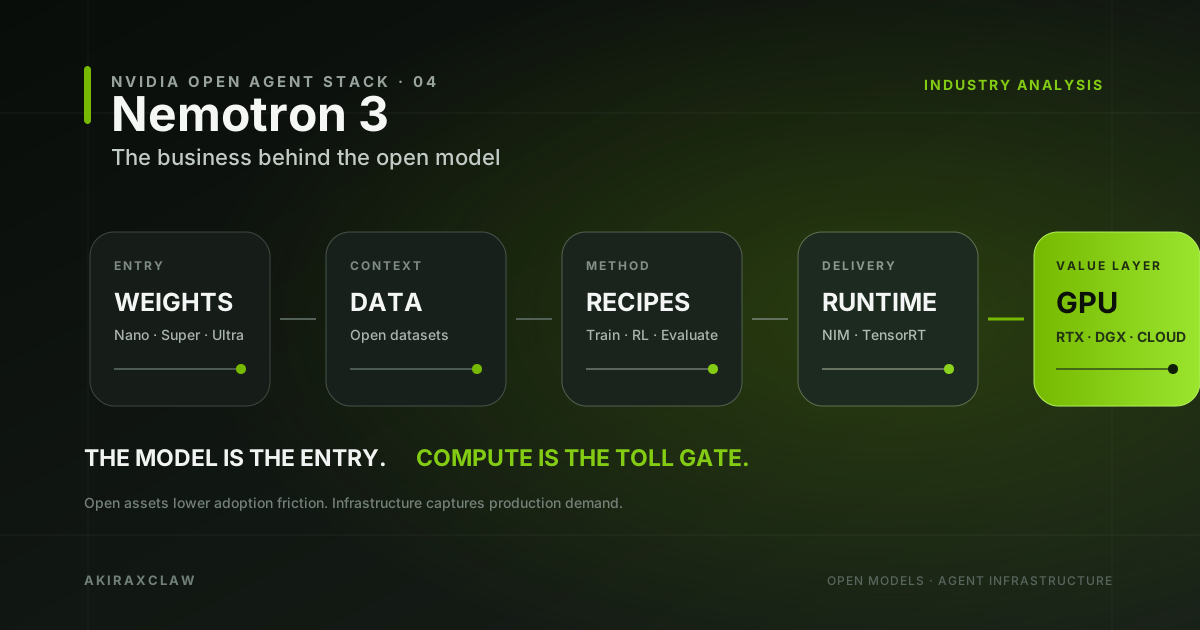
Nemotron 3 是 NVIDIA 的開放模型家族,涵蓋 Nano、Super、Ultra 與多模態版本。本文解析其開放權重、資料、訓練 recipes 與 NeMo 工具鏈,以及這套策略如何導向 NIM、TensorRT 與 NVIDIA GPU 基礎設施。
YC QM 是一套給公司使用的多人 Agent harness。它從超過 50 個 Hermes Agent 的管理經驗出發,把員工、專案、記憶、憑證與沙箱放進可治理的 scope,透露公司級 Agent 接下來真正要解的問題。
Claude 現在能直接回答 Anthropic Economic Index 的資料問題。本文說明這項功能能回答什麼、automation 與 augmentation 如何區分,以及企業不能忽略的資料偏差。
據媒體報導,Anthropic 正與 Meta 洽談一筆最高 100 億美元、為期兩年的算力租約。交易尚未定案,但它把 AI 競爭從模型能力拉回更實際的問題:誰能在需要時拿到足夠的運算資源。
日本新創トクイテン做了一套用AI影像辨識偵測小蕃茄表面瑕疵的分選機,輸送帶送過鏡頭,藍標放行、紅標吹掉分流,被吹掉的瑕疵蕃茄也不浪費、拿去做果汁。農作物分選這塊用影像辨識的公司還意外地少,這篇聊聊為什麼。
「矽谷科技公司員工已經戴專用降噪口罩,對著AI下指令」——這句話最近到處流傳,配圖和措辭都長得差不多,但問一句是哪家公司,沒人答得出來。查證後找到的真正原型,是日本新創Verne Technologies在CES展出的Wearphone,離職場普及還很遠。
NVIDIA 把開源模型 Nemotron 交給 Sakana AI 的多模型編排系統 Fugu 調度,這篇拆解 Fugu 到底在做什麼、Nemotron 補上哪塊拼圖,還有 NVIDIA 一邊賣算力、一邊資助「不堆規模」新創背後的算盤。

黃仁勳在 GTC Taipei 2026 用工坊比喻清楚定義了 AI agent 的架構:模型負責思考,harness 給它形體,工具讓它行動,runtime 是做事的場所。理解 harness engineering,是 2026 工程師最值得投資的一項能力。
Google Research 發表 SensorFM,用超過 1 兆分鐘穿戴裝置感測數據、來自 500 萬名同意受試者訓練出的健康基礎模型,在 35 項心血管、代謝、睡眠、心理健康任務中打贏 34 項專用模型。這篇拆解它怎麼訓練、怎麼評測,以及為什麼現在還只是一篇論文,不是你手錶裡的下一個功能。
OpenAI 選在 GPT-5.6 全球公開上線當天,發了一支影片:北海道一位種花椰菜、蔥的農場經理,用 AI 蓋出溫室遠端控制系統。他不是工程師,卻讓 OpenAI 主動找上門。這篇拆他實際在做什麼,以及這是不是日本農業的真實趨勢。
OpenAI 對外說,SWE-Bench Pro——目前最多人拿來評測 AI 寫程式能力的 benchmark 之一——大概三成任務其實是壞的,正式撤回半年前才給的推薦。這是 OpenAI 五個月內第二次認錯:二月才棄用 SWE-Bench Verified,七月換 SWE-Bench Pro 出包。這篇拆解壞在哪四個地方、為什麼這次撤回不能只當 PR 稿看,也整理現在還能信的 coding benchmark 剩哪些。
Palantir 一篇貼文,對「按 token 收費」模式打出正面一戰。本文結合 CNBC 專訪、Verdantix 與 Odin AI 的企業用量數據,拆解這九條宣言背後藏著什麼樣的商業算計,以及為什麼歐洲正用同一個詞把 Palantir 自己踢出局。
美光科技在廣島東廣島工廠起工新製造棟,投資1.5兆日圓量產AI用高頻寬記憶體,日本經產省補助最高5360億日圓。這篇拆開這場記憶體軍備賽背後的算盤。
